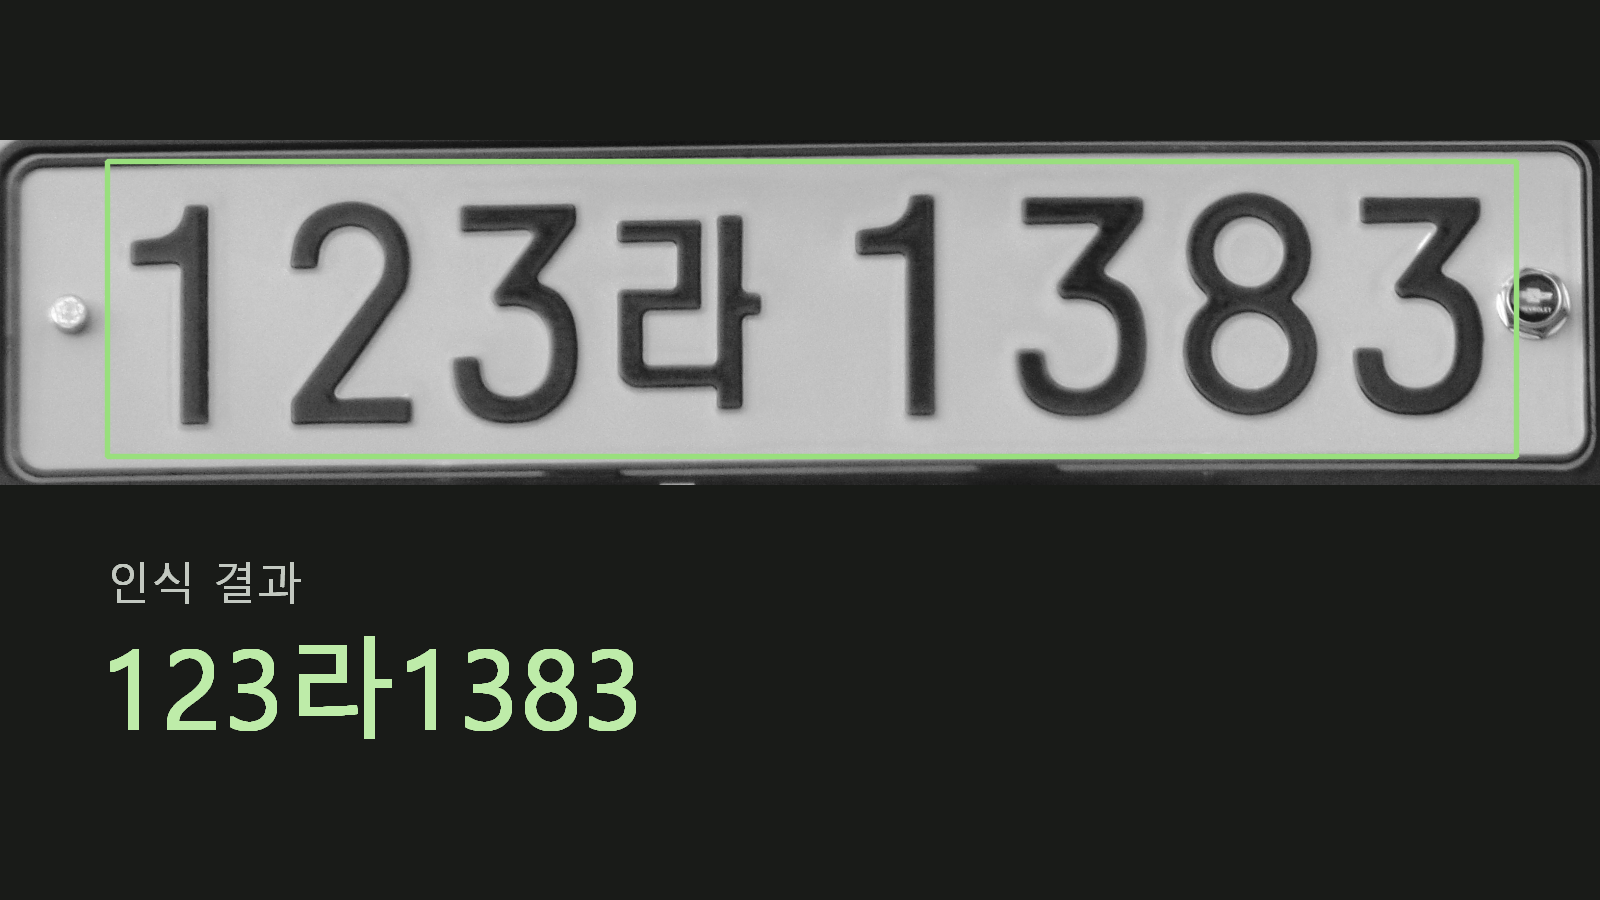
일반 한 줄 번호판의 인식 결과: 123라1383. 사진과 엔진이 반환한 문자열을 함께 표시. 사진 출처
1. 개요
한국 번호판의 한글과 숫자를 읽는 C++ 프로그램을 개인 프로젝트로 구현했다. 사진을 입력하면 인식한 번호와 번호판의 좌표를 반환한다.
문자 검출·인식에는 사전학습 모델을 사용하고, 번호판에 맞게 추가 학습과 영상처리를 적용했다. 기울기 보정, 두 줄 번호판의 조합, 작은 지역명 처리, 번호 형식 검사는 C++ 엔진에서 구현.
- 구현 언어: C++17
- 입력: 사진 전체 또는 번호판 영역
- 출력: 인식 번호, 원본 좌표, 확인이 필요한 후보
- 실행: 기기 내에서 처리
2. 인식 과정
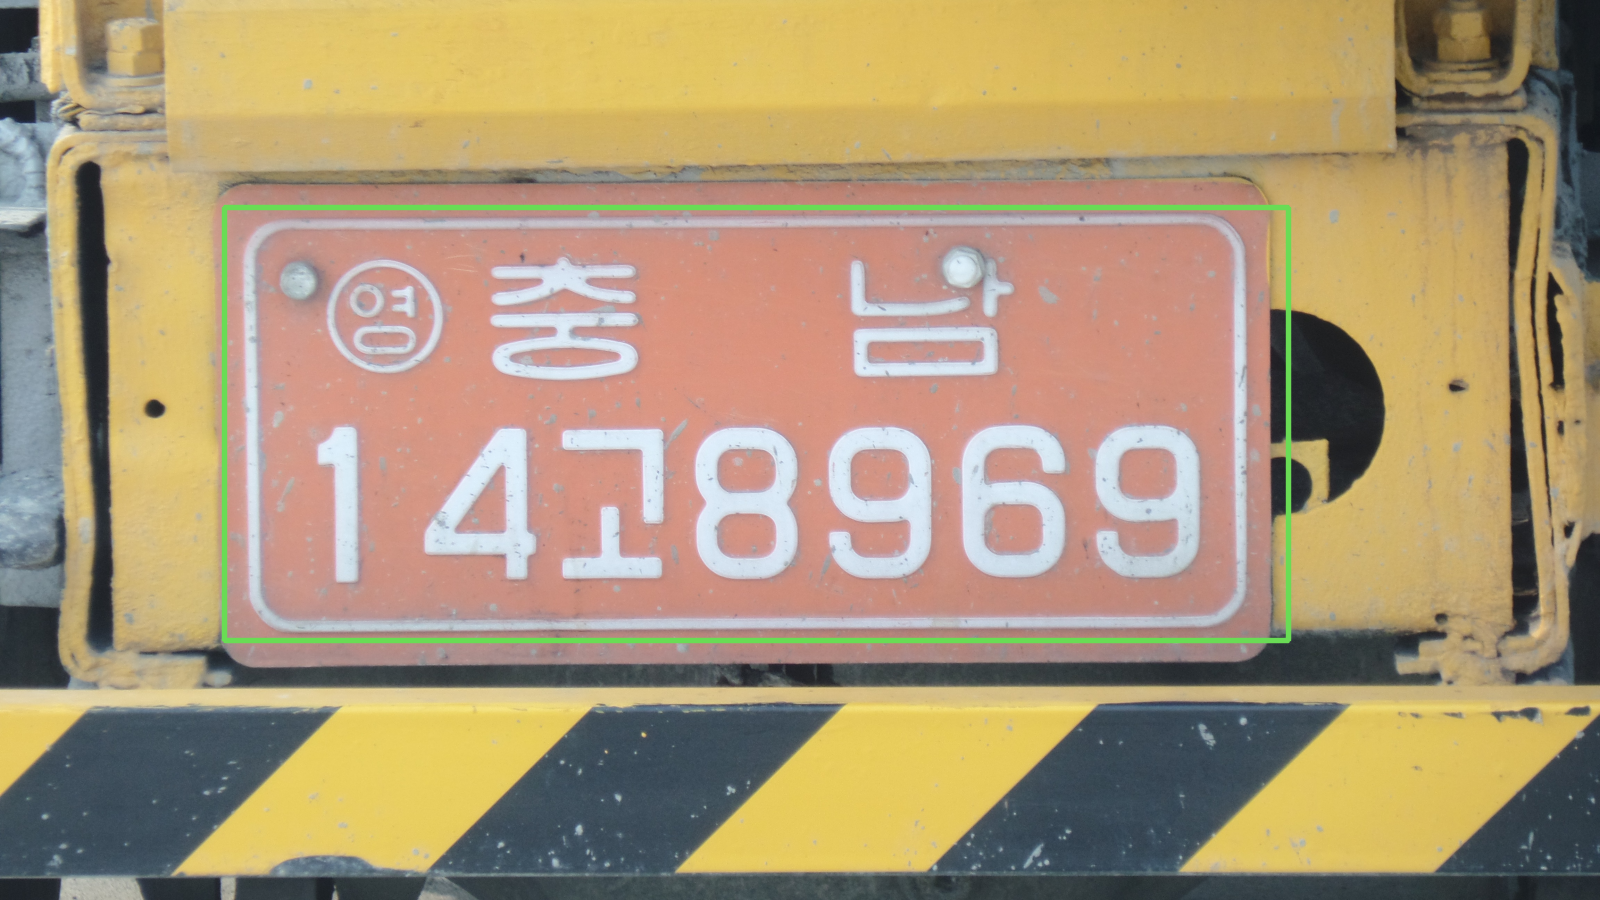
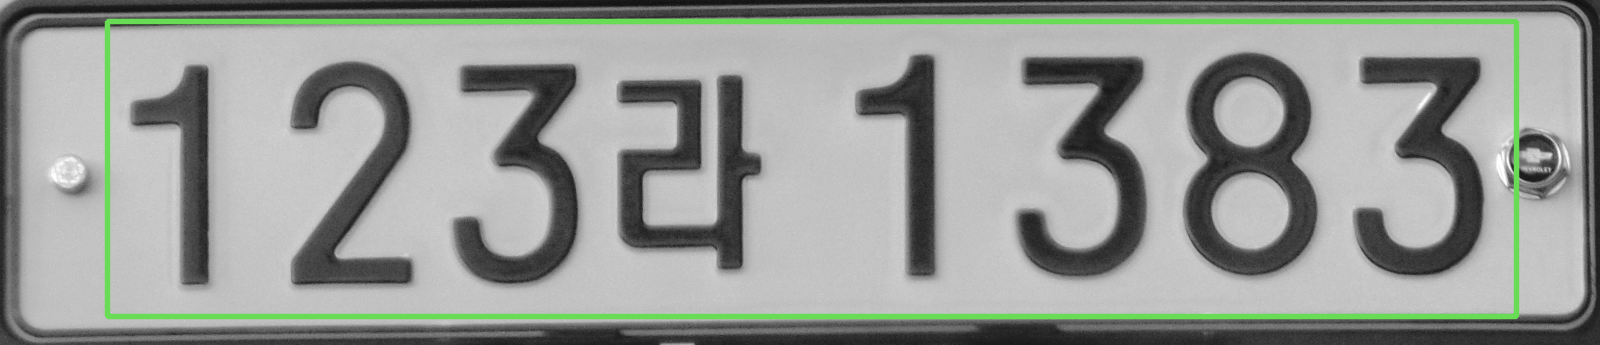
아래 이미지는 C++ 엔진을 실행하면서 저장한 중간 결과이다. 입력 이미지의 긴 변은 1,600px로 맞췄으며, 초록색 상자는 최종 인식 영역을 표시한 것.
정상 인식된 3개 예시로 처리 과정을 정리했다. 기본 동작 검증과 조건별 시험 결과는 4절에 정리.
2.1. 지역명이 있는 두 줄 번호판
윗줄에는 지역명, 아랫줄에는 번호가 있는 형태. 두 줄의 글자 크기가 다르기 때문에 각각 인식한 뒤 결합한다.
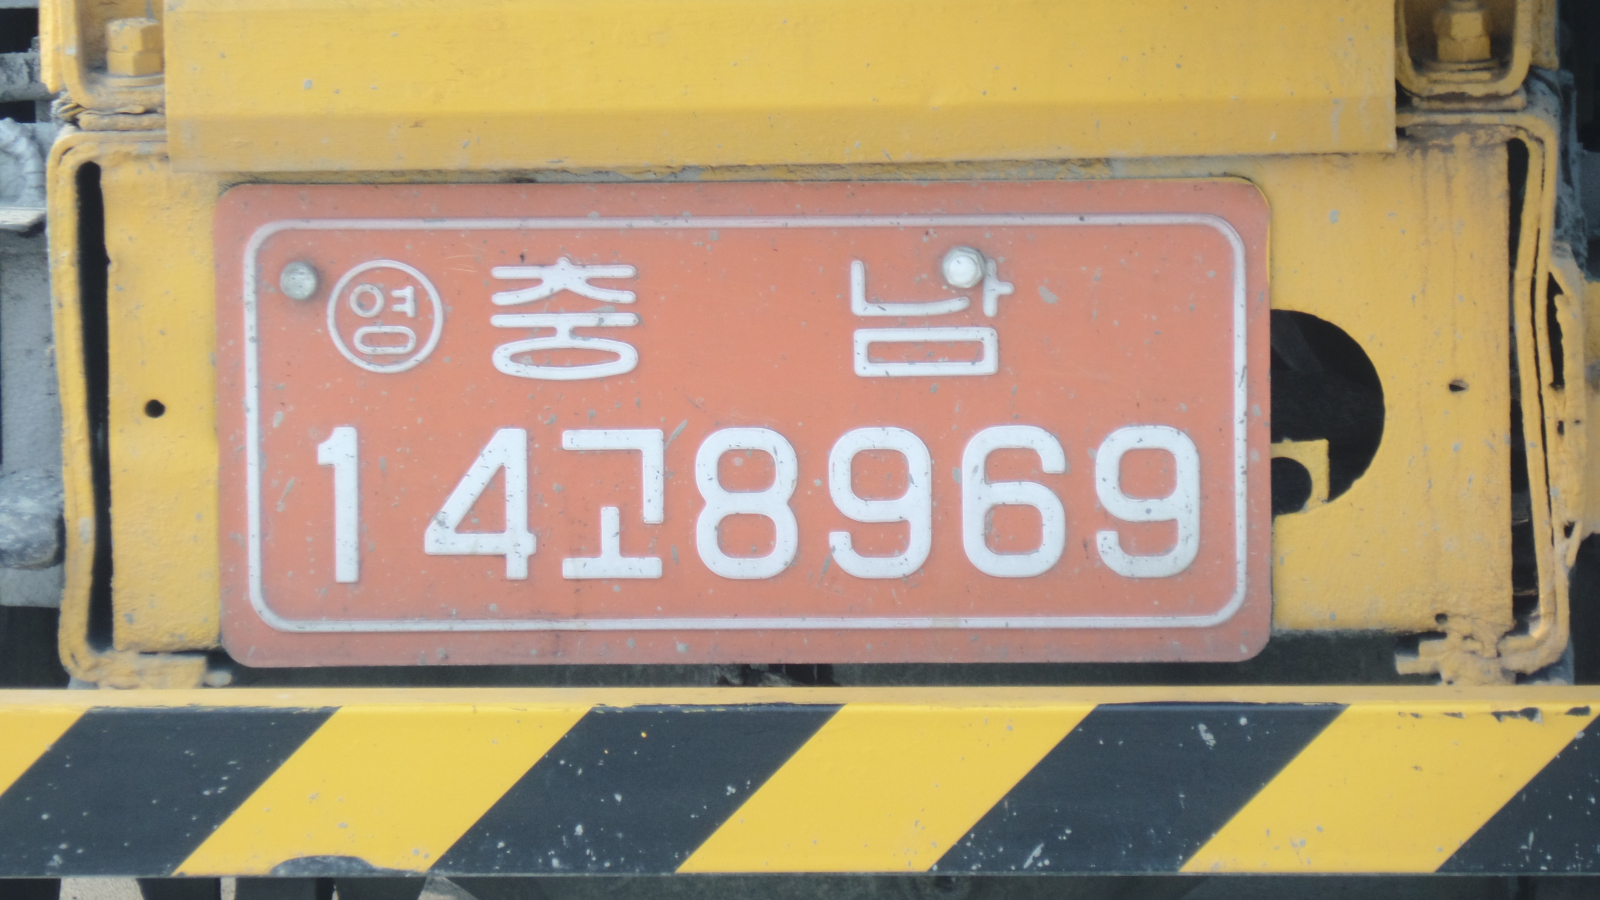
1) 입력 이미지
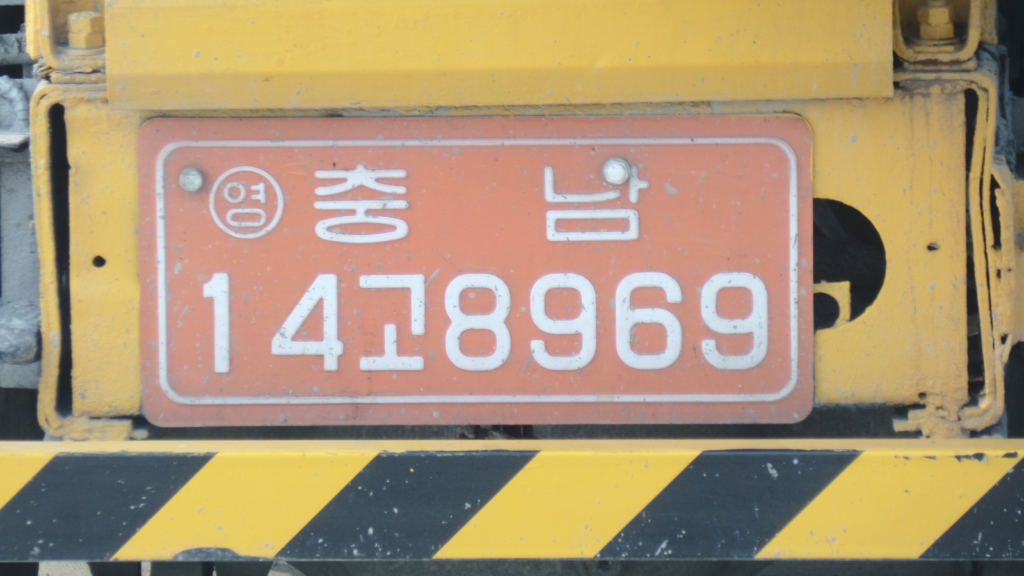
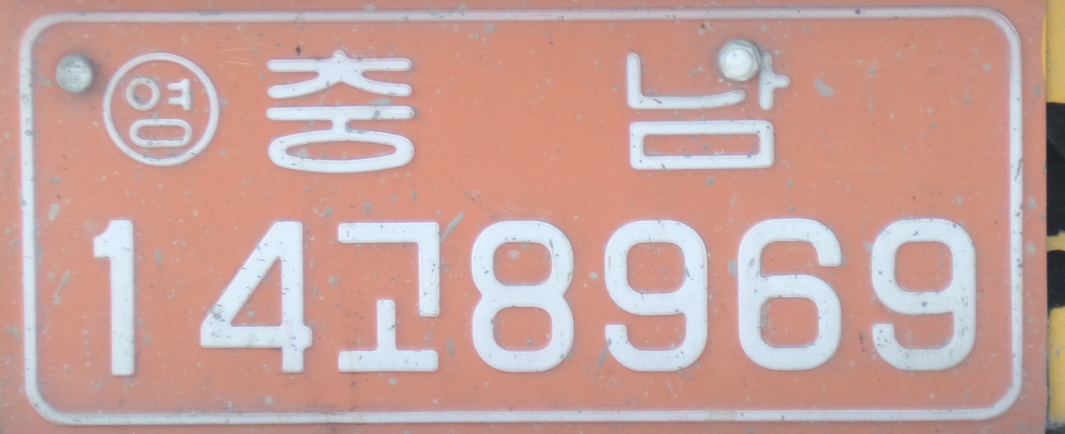
엔진에 입력한 원본 이미지 2) 번호판 영역 추출 및 기하 보정
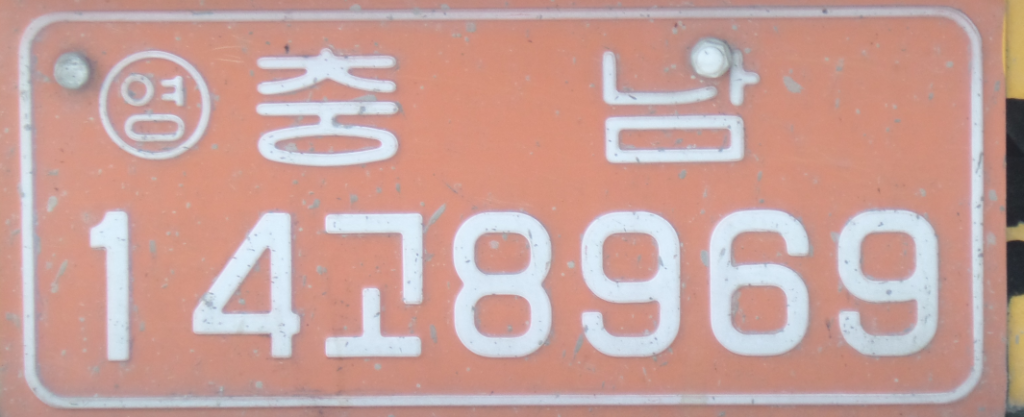
번호판 영역을 추출한 뒤 기울기와 원근을 보정 3) 윗줄 인식
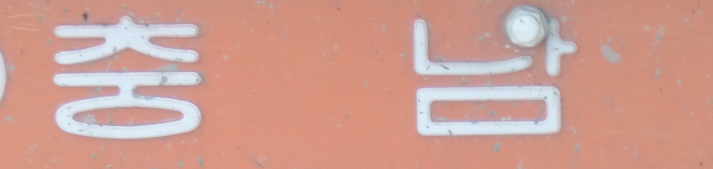
인식 원문: 충남
지역명이 있는 윗줄을 분리해서 인식 4) 대비 보정 후 재인식
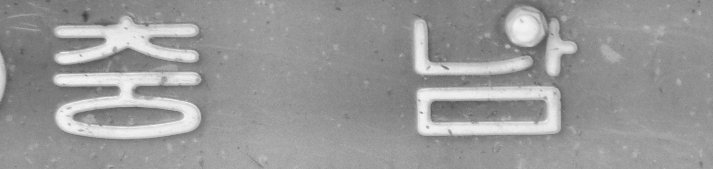
재시도 원문: 충 남
윗줄의 대비를 보정한 뒤 재인식한 결과 5) 아랫줄 인식
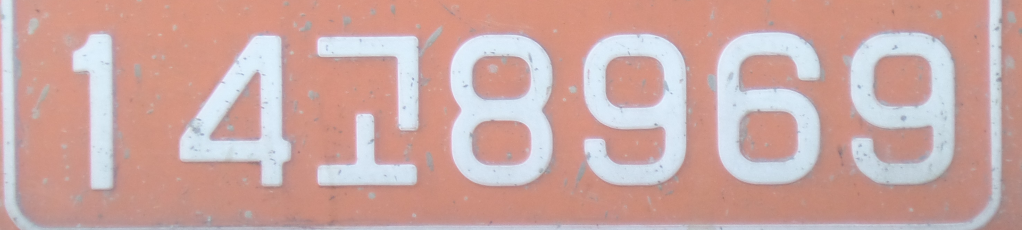
인식 원문: 14고8969
숫자와 한글이 있는 아랫줄을 분리해서 인식 6) 최종 결과
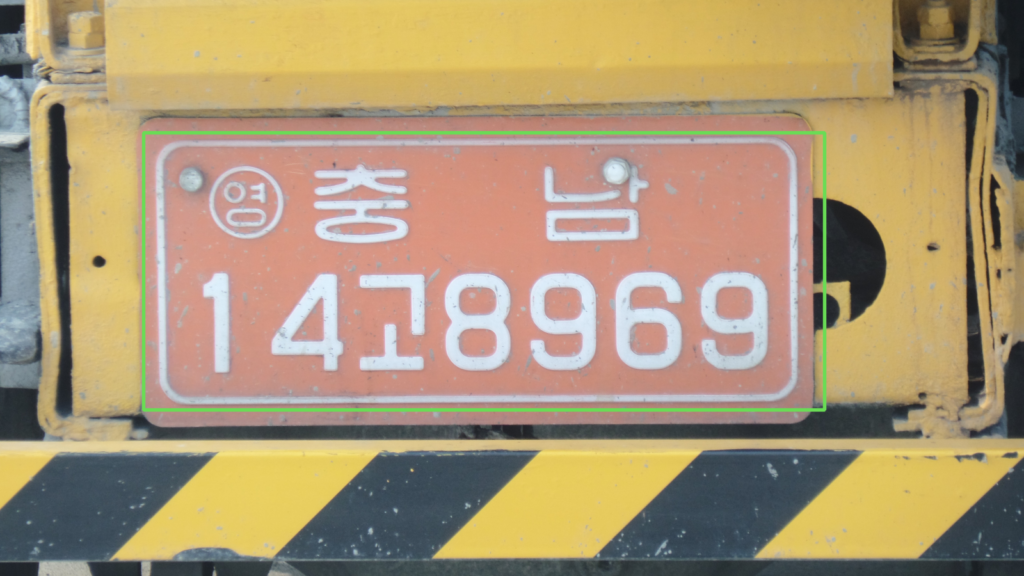
최종 결과: 충남14고8969
충남 + 14고8969 → 두 줄을 결합하고 번호 형식을 확인
2.2. 기울어진 두 줄 번호판
같은 방식으로 기울어진 번호판도 확인. 아래 입력은 지게차 번호판 사진에 사선 변형을 준 테스트 이미지이다.
1) 입력 이미지
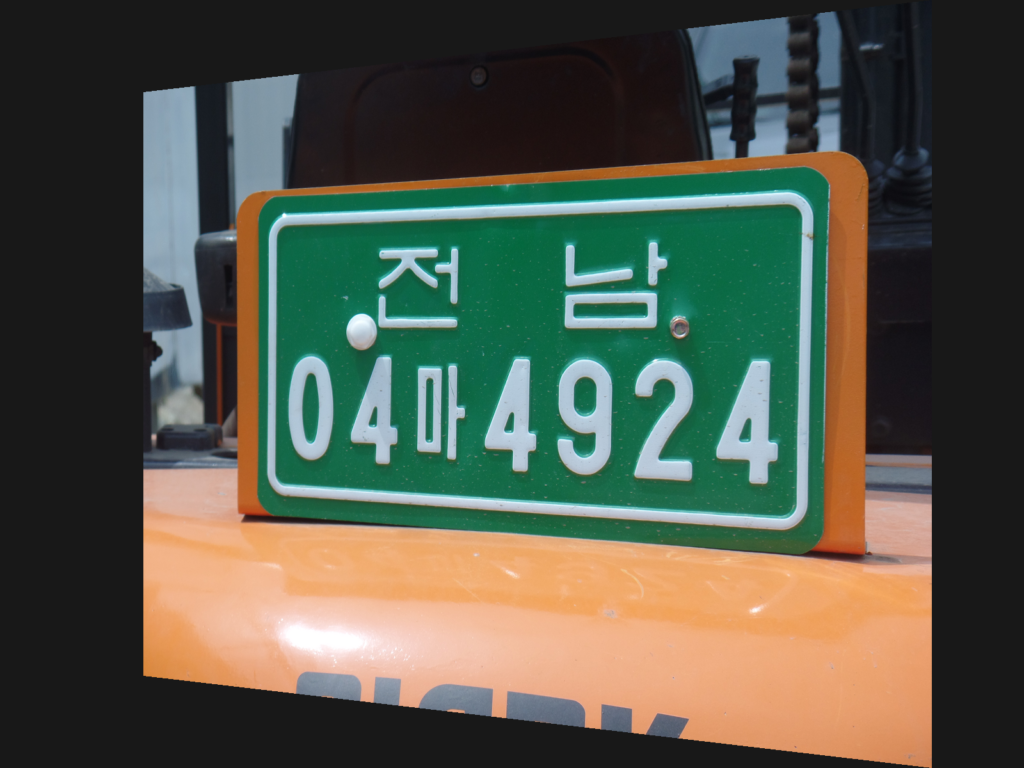
엔진에 입력한 원본 이미지 2) 번호판 영역 추출 및 기하 보정
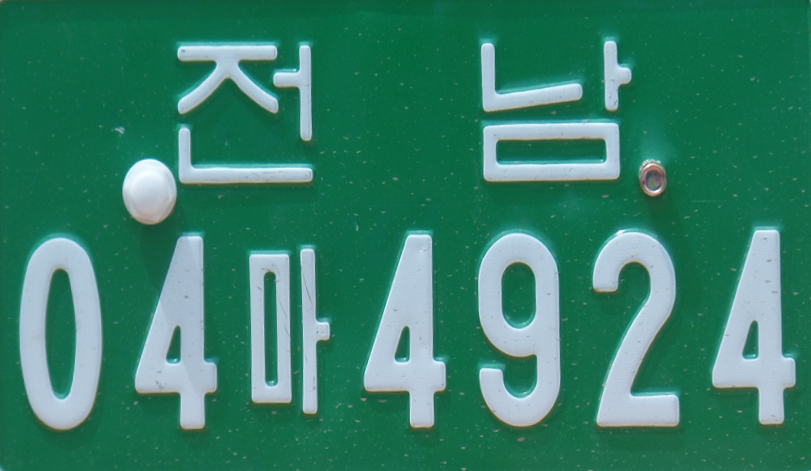
번호판 영역을 추출한 뒤 기울기와 원근을 보정 3) 윗줄 인식
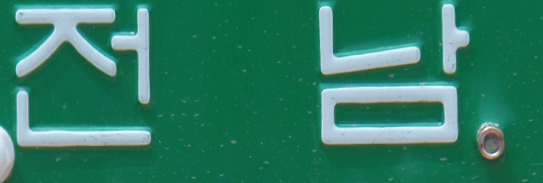
인식 원문: 전 남
지역명이 있는 윗줄을 분리해서 인식 4) 대비 보정 후 재인식
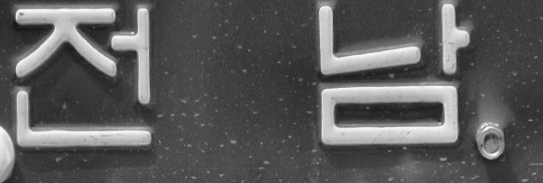
재시도 원문: 전남.
윗줄의 대비를 보정한 뒤 재인식한 결과 5) 아랫줄 인식
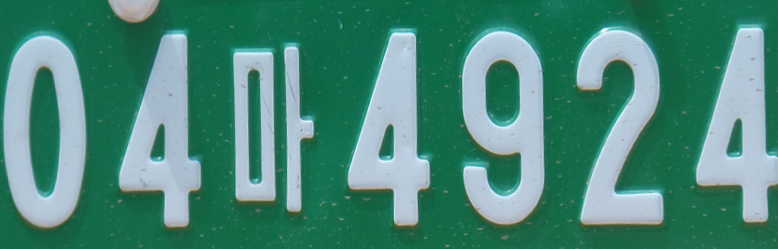
인식 원문: 04마4924
숫자와 한글이 있는 아랫줄을 분리해서 인식 6) 최종 결과
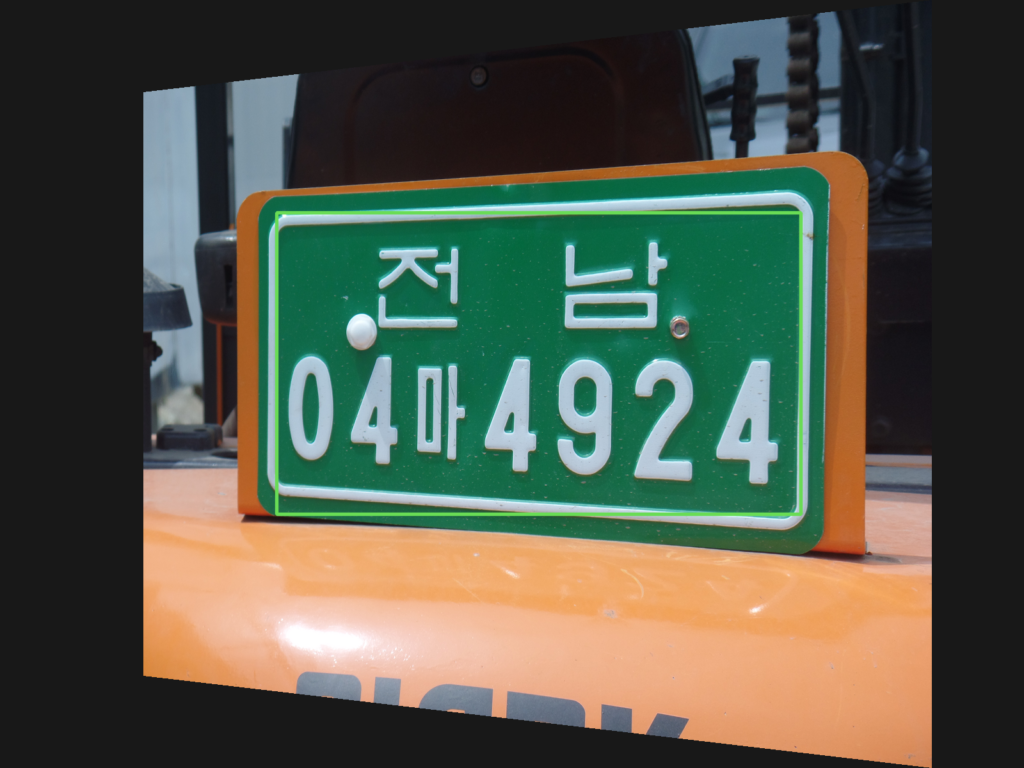
최종 결과: 전남04마4924
전 남 + 04마4924 → 공백을 정리하고 번호 형식을 확인
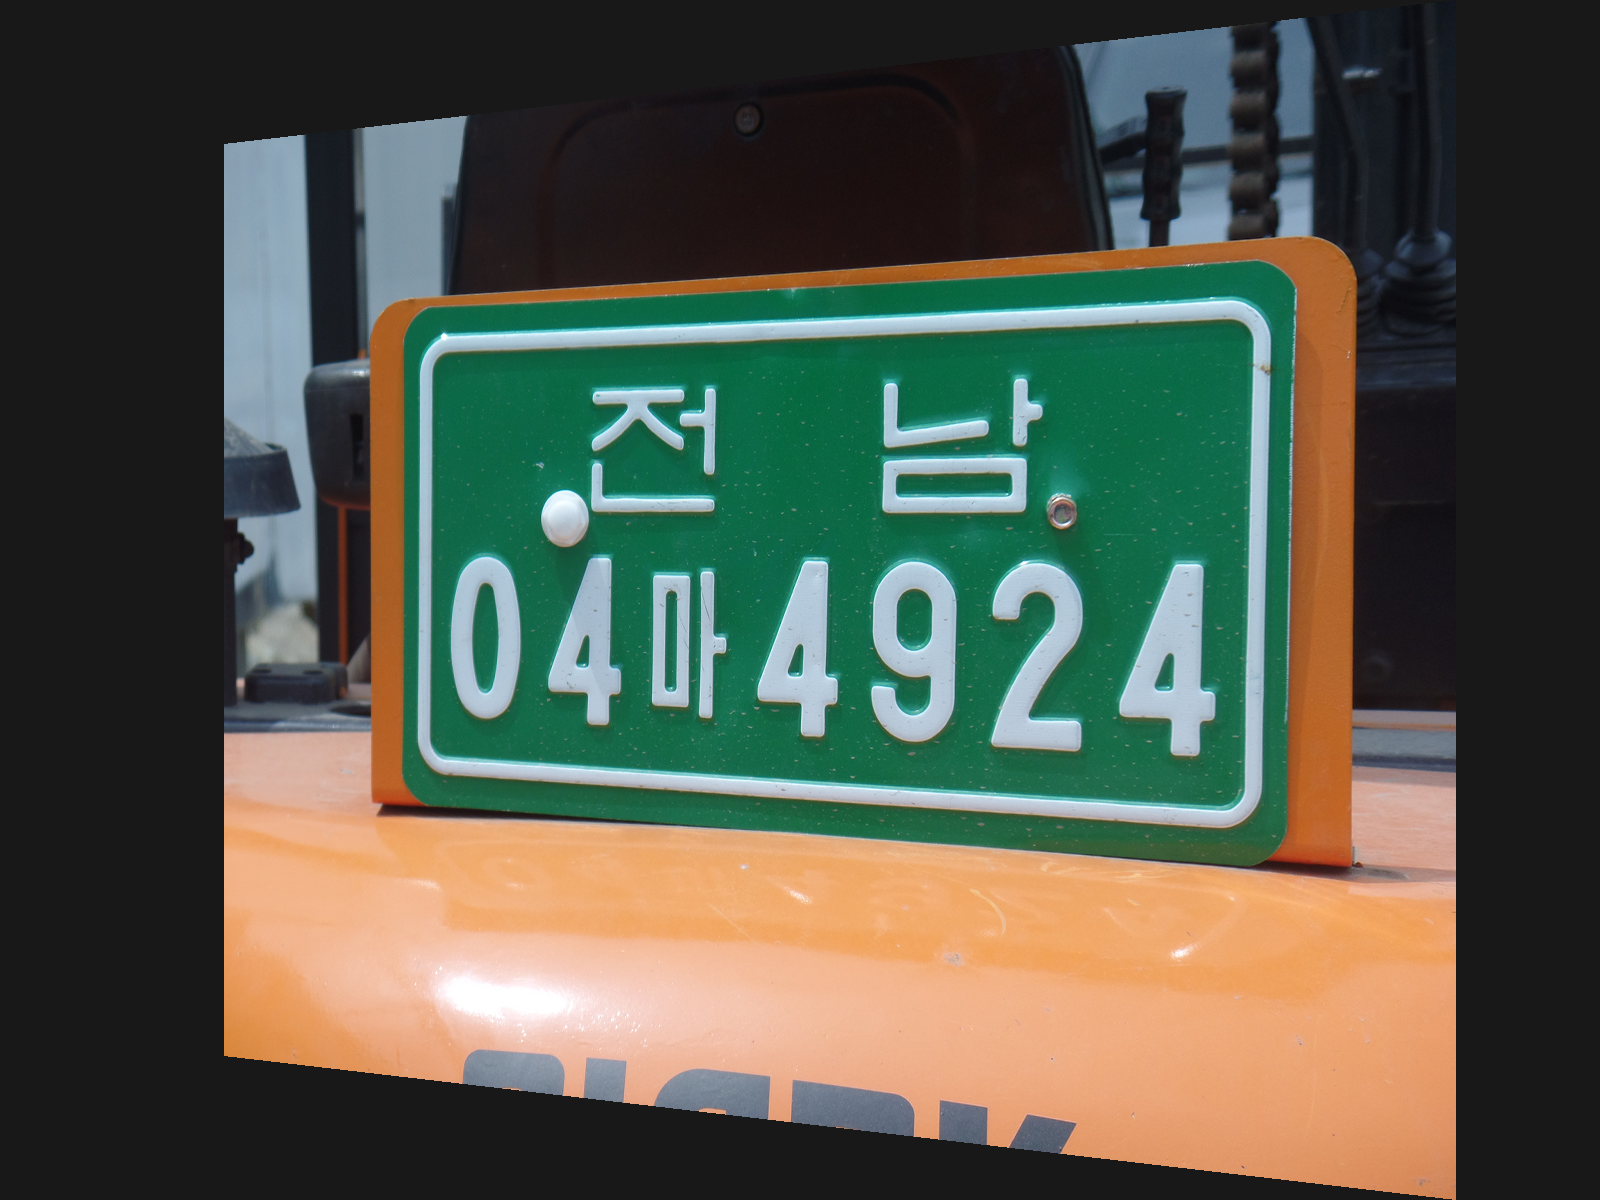
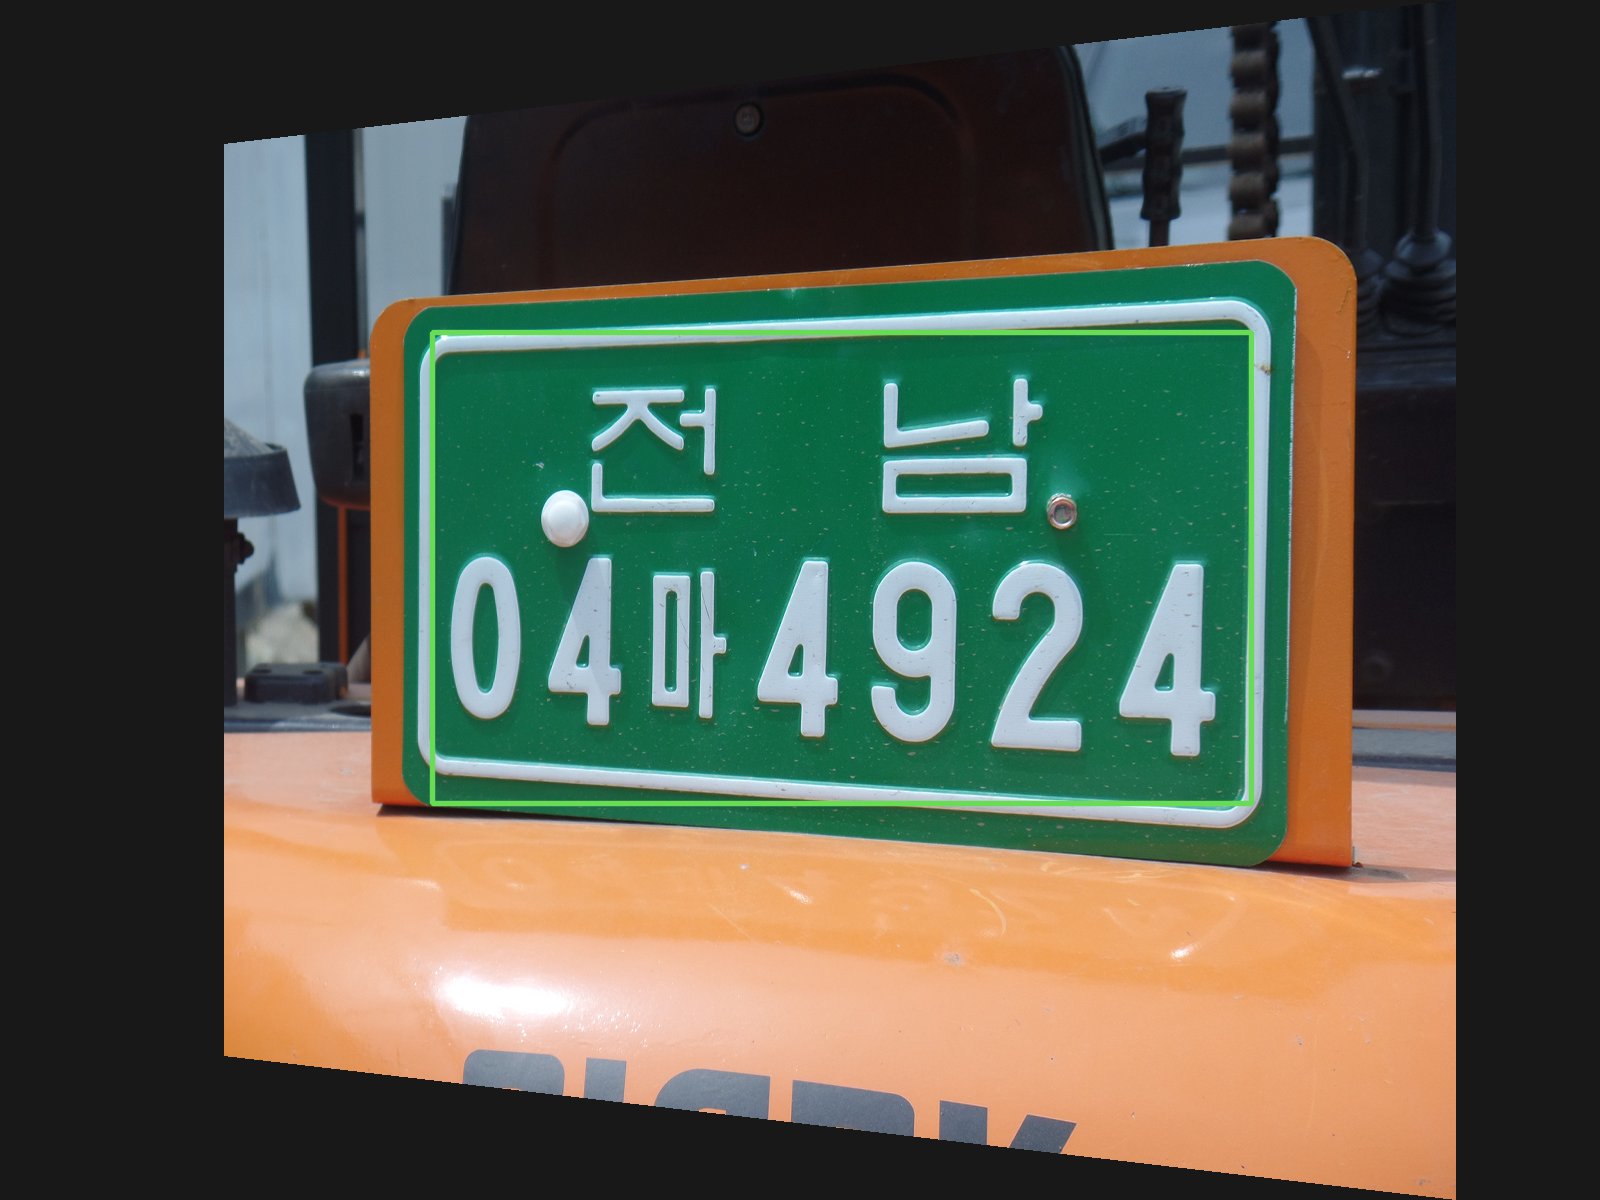
윗줄은 전 남, 재시도에서는 전남.으로 읽힘. 최종 조합에는 전 남과 아랫줄의 04마4924를 사용하고, 공백을 정리해 전남04마4924로 확정.
2.3. 한 줄 번호판
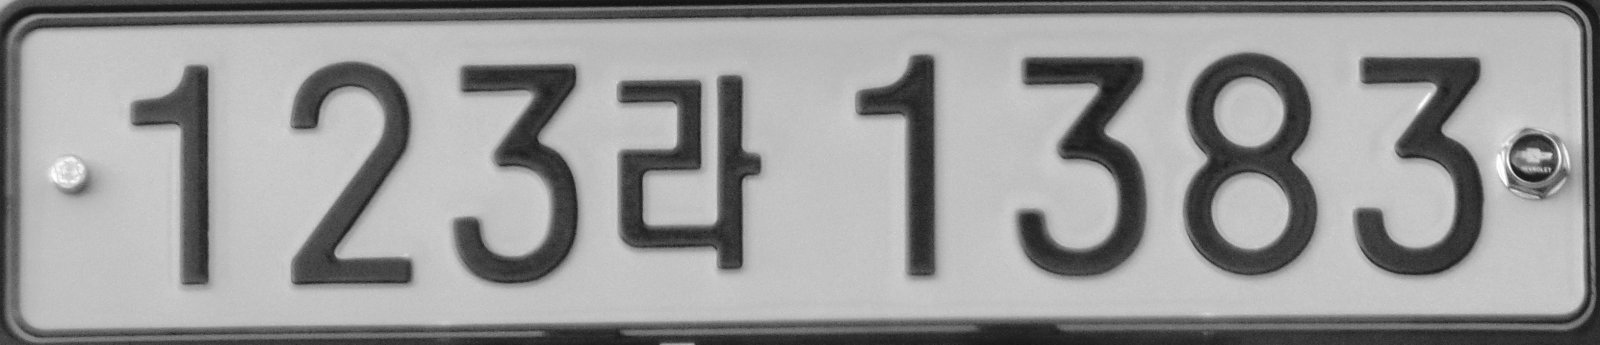
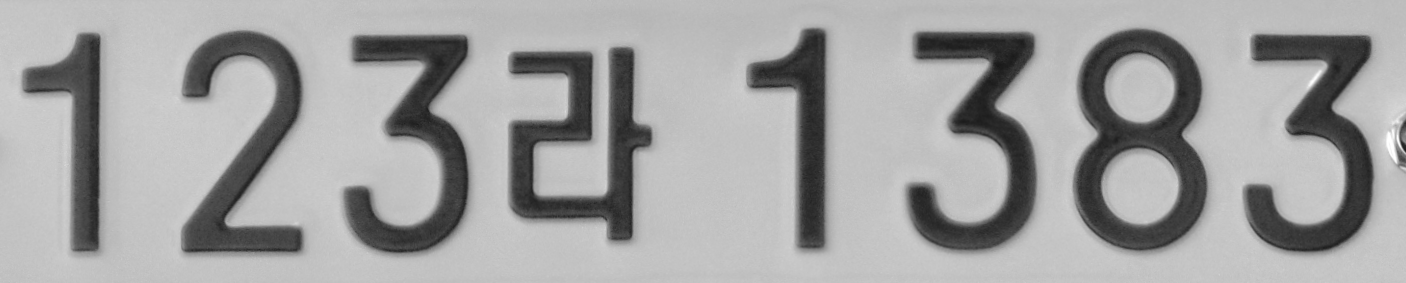
앞자리 숫자가 세 개인 한 줄 번호판. 이 경우에는 문자 영역을 보정한 뒤 한 번의 인식으로 번호가 확정되어, 줄 분리나 대비 보정 재시도는 거치지 않음.
1) 입력 이미지
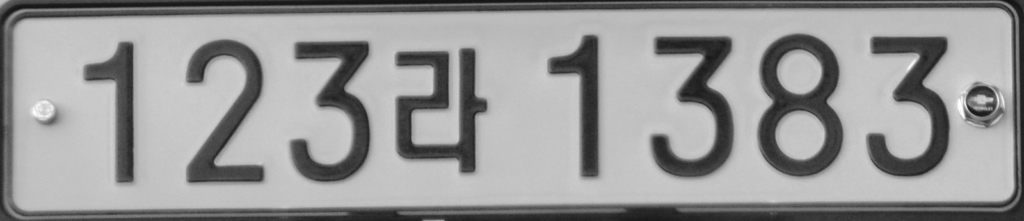
한 줄 번호판 입력 2) 문자 영역 보정 및 인식
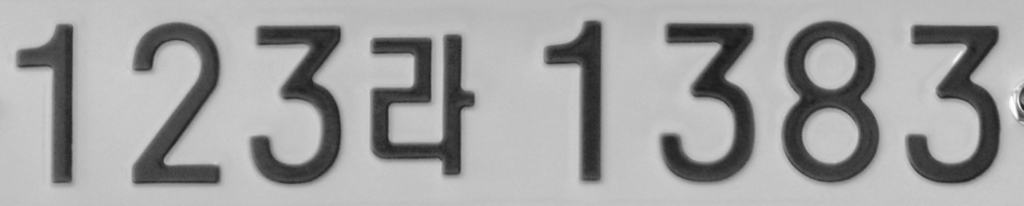
인식 원문: 123라1383
문자 영역을 보정한 뒤 인식 3) 최종 결과
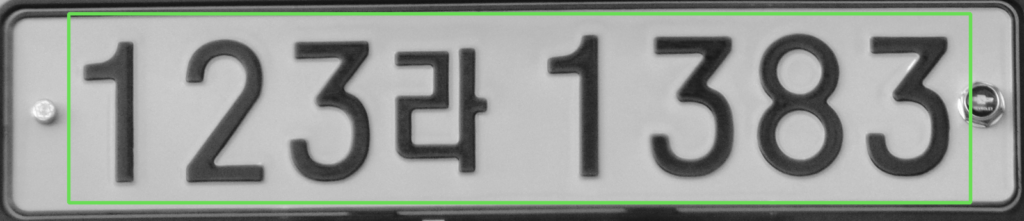
최종 결과: 123라1383
인식 번호와 원본 이미지에서의 좌표를 반환
3. 구현
3.1. 전체 흐름
- 원본 이미지사진 전체 또는 잘라낸 번호판 영역을 입력
- 문자 영역 탐색글자가 있는 영역과 좌표 검출
- 기하 보정과 행별 이미지 추출기울기와 원근 보정. 두 줄 번호판은 위아래 줄을 분리
- 딥러닝 문자 인식한글·숫자 문자열과 문자별 점수 출력
- 지역명·여러 줄 결합과 결과 검증글자의 위치, 번호판 형식, 인식 점수를 확인해 결과 조합
- 인식 번호와 원본 좌표 출력확정된 번호와 좌표 반환. 확인이 필요한 후보는 별도 구분
모든 이미지가 같은 경로를 거치는 것은 아니다. 결과가 불완전한 경우에는 원본에서 작은 영역을 다시 찾거나, 글자 비율을 보정해서 재인식. 일부 한글은 추가 학습한 인식기로 다시 확인한다.
3.2. 문자 인식
잘라낸 문자 이미지에서 특징을 추출한 뒤, 가로 방향으로 어떤 글자가 있는지 판단한다. 각 위치의 문자 확률을 CTC 방식으로 정리하면 문자열을 얻을 수 있음.
- 시각적 특징 추출CNN으로 획과 형태의 특징을 추출
- 문자열 특징 해석가로 방향 특징과 문맥의 관계를 반영
- 문자 확률 계산각 시점에서 가능한 문자의 점수 계산
- CTC 디코딩빈 기호·연속 중복을 정리해 문자열 출력
CTC는 연속된 중복 문자와 빈 기호를 정리하는 방식이다. 예를 들어 아래와 같은 출력이 나오면 12가3으로 정리된다.
[1, 1, 빈 기호, 2, 가, 빈 기호, 3] → 12가3
CTC 설명을 위한 예시이며 실제 인식 결과는 아님.
번호판 글꼴과 배치에 맞춰 문자 인식 모델을 추가 학습했다. 새 모델에서 좋아진 조건도 있지만 다른 형식에서 성능이 떨어지는 경우가 있어, 비교 결과에 따라 일부 한글을 재검토하는 용도로 적용.
3.3. 지역명과 두 줄 번호판 처리
지역명은 번호보다 작게 찍히는 경우가 많다. 번호 부분만 먼저 확정하면 지역명이 빠진 채 결과가 나올 수 있음.
이를 처리하기 위해 검출 영역의 위치와 줄 관계를 비교하고, 지역명과 번호를 각각 읽어서 결합하도록 구현했다. 작은 글자를 읽지 못한 경우에는 주변 영역을 원본 해상도에서 다시 탐색.
3.4. 기울기와 글자 비율 보정
문자 영역과 번호판 테두리를 이용해 기울기와 원근을 보정한다. 다만 기울기를 바로잡아도 글자가 가로로 눌리거나 세로로 늘어난 상태이면 잘못 읽는 경우가 있음.
이 경우에는 연결 요소 분석으로 글자 묶음의 형태를 확인하고, 글자의 폭·높이 비율을 보정한 뒤 다시 인식하도록 했다. 확대와 보정은 함께 처리해 중간 이미지 변환에 따른 손실을 줄임.
3.5. 인식 결과 확인
읽은 문자열을 한국 번호판 형식과 비교하고 문자별 점수를 확인한다. 한 글자가 잘못 읽히거나 지역명이 누락된 번호를 그대로 확정하지 않도록, 확정 결과와 확인 후보를 구분.
여기서 문자별 점수는 모델의 판단 값이다. 점수가 높다고 실제 정답률이 그만큼 높다는 뜻은 아님.
4. 동작 검증 및 개선 결과
4.1. 기본 사진 검증
기존에 검증용으로 등록한 실제 사진 6장을 현재 C++ 엔진으로 다시 실행했다. 차량 전체 사진 5장과 번호판만 있는 사진 1장 모두 전체 번호가 일치했고, 추가 번호 출력은 없었음.
| 입력 | 전체 번호 일치 | 오인식 | 미인식 |
|---|---|---|---|
| 차량 전체 사진 | 5 / 5 | 0 | 0 |
| 번호판 영역 사진 | 1 / 1 | 0 | 0 |
2026년 9월 26일 재확인. 위 6장은 개발 중 사용한 기본 동작 검증용 사진이다. 실제 사용 환경을 대표하는 별도 표본의 전체 인식 정확도는 아직 측정하지 않음.
4.2. 글자 비율 보정 전후 비교
가로·세로 비율이 심하게 늘어난 번호판은 기울기만 보정해도 잘 읽히지 않았다. 글자 형태를 분석해 비율을 보정하고 다시 인식하도록 수정.
동일한 비율 왜곡 이미지 96장: 1 / 96 → 84 / 96
모델은 동일하게 두고 C++ 보정 경로만 변경한 결과이다. 수정 후 전체 번호 일치 84개, 오인식 3개, 미인식 9개. 이 96장은 번호판 주변을 잘라 비율을 늘린 개발용 이미지이며, 차량·도로 전체 사진은 아님.
함께 확인한 1,681개 시험 조건에서는 165개를 추가로 맞혔고, 기존에 성공했던 조건이 실패로 바뀐 경우는 없었음. 같은 사진의 크롭과 변형도 각각 포함한 조건 수이다.
4.3. 조건별 개발 시험
작은 글자, 구형·특수번호판, 비율 왜곡과 블랙박스 입력을 따로 시험했다. 인식 범위를 넓히고 수정 전후의 차이를 확인하기 위한 자료로, 입력 조건과 같은 사진의 반복 횟수가 서로 다르다.
아래 수치는 각 시험 조건 안에서의 결과이다. 이를 합산한 값을 시스템 전체 인식 정확도로 사용하지 않음.
조건별 일치·오인식·미인식 결과 보기
2026년 9월 16일 배포 엔진으로 확인한 개발·회귀 시험 결과.
- 전체 번호가 정확히 일치해야 성공
- 한 글자 오독과 지역명 누락도 오인식으로 처리
- 한 화면에 번호판이 여러 개이면 모두 맞아야 함
- 불필요한 번호가 추가로 출력되어도 성공에서 제외
| 시험 조건 | 완전 일치 | 오인식 | 미인식 | 일치 비율 |
|---|---|---|---|---|
| 블랙박스 전체 화면 | 144 / 300 | 58 | 98 | 48.0% |
| 구형·특수번호판 등 변형 시험 | 189 / 280 | 17 | 74 | 67.5% |
| 작은 번호판 전체 화면 시험 | 49 / 210 | 11 | 150 | 23.3% |
| 비율이 왜곡된 개발 이미지 | 84 / 96 | 3 | 9 | 87.5% |
구형·특수번호판 시험은 공개 사진 35장에 크기·밝기·사선 변형을 준 280조건. 작은 번호판 시험은 같은 사진의 번호판 높이를 12~48px로 축소·배치한 조건을 포함한다.
블랙박스 결과는 일부 누락된 번호판 라벨과 의심 정답을 그대로 둔 검수 전 잠정 수치. 비율 왜곡 96장은 보정 기능 개발에 사용한 자료이다.
번호판 영역만 잘라서 입력한 결과 및 추가 시험
| 시험 조건 | 완전 일치 | 오인식 | 미인식 | 일치 비율 |
|---|---|---|---|---|
| 블랙박스 번호판 크롭 | 169 / 353 | 55 | 129 | 47.9% |
| 작은 번호판 크롭 | 55 / 210 | 23 | 132 | 26.2% |
| 비율 왜곡 이미지의 정답 크롭 | 82 / 96 | 8 | 6 | 85.4% |
| 공개 사진의 가로 압축 시험 | 4 / 4 | 0 | 0 | 100.0% |
크롭 시험은 사람이 지정한 번호판 영역을 잘라 입력한 결과. 가로 압축 시험은 같은 공개 사진 1장을 네 가지로 변형한 것이다. 전체 화면 시험과 입력 조건이 다르므로 수치를 직접 비교하기는 어려움.
현재는 입력 크기와 글자 상태에 따른 차이가 있으며, 작은 지역명과 흐림, 야간 영상은 추가 개선이 필요.
원본 사진: Jhcbs1019 / Wikimedia Commons, CC BY-SA 4.0.
변경: 입력 크기 조정, C++ 엔진의 영역 추출·기하 보정·행 분리·대비 보정, 최종 인식 좌표 표시. 2.2절의 입력에는 사선 변형을 적용. 처리 이미지도 CC BY-SA 4.0으로 제공.